Membangun Chatbot Portfolio di Edge dengan Astro dan Cloudflare Workers AI
Catatan teknis mengintegrasikan chatbot interaktif pada portfolio berbasis Astro menggunakan Cloudflare Workers AI: arsitektur edge, pemilihan model Qwen 2.5 Coder, mitigasi downtime, dan optimasi kuota gratis.
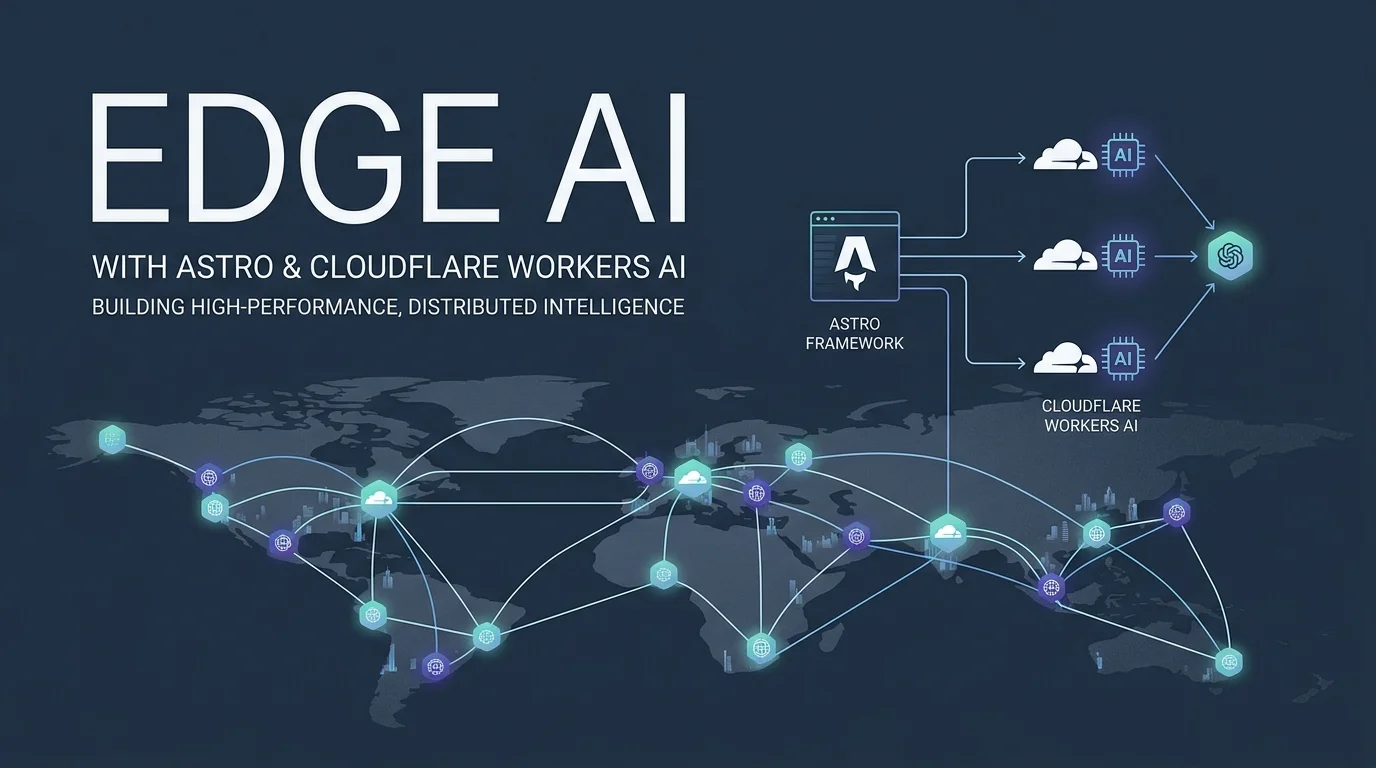
Menambahkan fitur interaktif berbasis AI seperti “Ask the Portfolio” di situs pribadi terdengar menarik di atas kertas: pengunjung bisa langsung menanyakan pengalaman kerja, stack yang dikuasai, atau detail proyek tanpa harus menelusuri seluruh halaman secara manual.
Namun, mengoperasikan LLM untuk portfolio web publik punya tantangan realitas tersendiri:
- Biaya & Quota Expiry: Menggunakan API komersial berbayar per-token sering kali memicu kekhawatiran tagihan membengkak akibat bot crawler atau scraper liar.
- Model Lifecycle & Deprecation: API gratisan atau trial developer (misal: Nvidia NIM / OpenRouter) sering mengalami perubahan rute, kuota hangus tiba-tiba, atau model mendadak dimatikan (End of Life) dengan error
410 Gone. - Latensi & Edge Distance: Jika portfolio di-host di edge CDN (seperti Vercel atau Cloudflare), memanggil server LLM yang berada jauh di origin server lain menambah waktu tunggu (TTFT) yang membuat antarmuka terasa lambat.
Untuk mengatasi ini, saya memindahkan backend chatbot portfolio saya ke Cloudflare Workers AI, memanfaatkan integrasi OpenAI-compatible endpoint langsung dari serverless route Astro.
Arsitektur Integrasi
Sistem ini memisahkan antara antarmuka web, logika serverless, dan inference LLM di edge:
Pengunjung Web (Browser)
       │
       ▼ POST /api/chat (Payload: message, history, deviceId)
Vercel Edge Serverless Function (Astro API Route)
       │
       ├── Rate Limiter (IP & Fingerprint in-memory window)
       ├── Prompt Assembly (System context + CV + Project slugs)
       │
       ▼ HTTPS POST /v1/chat/completions (OpenAI Compatible)
Cloudflare Workers AI (Global Edge Network)
       │
       ▼ Inferences: @cf/qwen/qwen2.5-coder-32b-instruct
Response Streaming / JSON ➔ Dikirim kembali ke Chatbot Island
Dengan pola ini:
- API Key tidak pernah bocor ke client-side: Semua request dirutekan lewat endpoint internal
/api/chat.ts. - Koneksi OpenAI-Compatible: Library
@langchain/openaiatau SDK standar OpenAI tetap bisa digunakan tanpa perlu library SDK khusus Cloudflare. Cukup ubahbaseURLdanapiKey.
Mengapa Memilih Qwen 2.5 Coder di Edge?
Cloudflare Workers AI menyediakan beragam katalog model open-weights pada tier gratis (alokasi 10.000 neurons per hari). Dari pengujian beberapa model, ada perbedaan karakteristik yang signifikan:
1. Model Reasoning (DeepSeek-R1 / QwQ) Kurang Cocok untuk UI Chatbot
Model dengan kemampuan penalaran (reasoning) cenderung menghasilkan thinking tokens yang panjang sebelum menjawab. Di antarmuka chat portofolio, ini menghabiskan kuota max_tokens dan memperpanjang latensi tunggu hingga 5–8 detik sebelum teks pertama muncul.
2. Llama 3.1 8B vs Qwen 2.5 Coder 32B
@cf/meta/llama-3.1-8b-instruct-fp8: Sangat cepat dan sangat hemat kuota (~0.76 neuron per respons), namun terkadang kurang luwes menangani istilah teknis monorepo dan Bahasa Indonesia kasual secara bersamaan.@cf/qwen/qwen2.5-coder-32b-instruct: Menjadi pilihan ideal. Model ini dilatih mendalam pada kode dan dokumentasi teknis, sangat presisi mengenali perbedaan teknologi (misal: membedakan peran NestJS di backend vs Nuxt di frontend), serta memiliki kemampuan dwibahasa (Indonesia - Inggris) yang sangat natural tanpa halusinasi.
Implementasi Serverless Endpoint Astro
Pada file src/pages/api/chat.ts, konfigurasi LangChain dihubungkan ke endpoint Workers AI:
import type { APIContext } from 'astro';
import { ChatOpenAI } from '@langchain/openai';
import { SystemMessage, HumanMessage, AIMessage } from '@langchain/core/messages';

export const prerender = false; // Memastikan route berjalan dinamis (SSR)

export async function POST({ request }: APIContext) {
    const { message, history = [] } = await request.json();

    const apiKey = process.env.LLM_API_KEY;
    const baseURL = process.env.LLM_BASE_URL; // https://api.cloudflare.com/client/v4/accounts/<ACCOUNT_ID>/ai/v1
    const modelName = process.env.LLM_MODEL || '@cf/qwen/qwen2.5-coder-32b-instruct';

    // Inisialisasi client dengan timeout ketat
    const cleanBaseURL = baseURL ? baseURL.trim().replace(/\/+$/, '') : undefined;
    const chat = new ChatOpenAI({
        apiKey,
        model: modelName,
        temperature: 0.5,
        maxTokens: 512,
        timeout: 10000, // 10 detik batas waktu
        maxRetries: 1,
        configuration: {
            baseURL: cleanBaseURL,
            apiKey,
        },
    });

    const messages = [
        new SystemMessage(systemPrompt),
        ...history.map(m => m.sender === 'user' ? new HumanMessage(m.content) : new AIMessage(m.content)),
        new HumanMessage(message),
    ];

    try {
        const response = await chat.invoke(messages);
        return new Response(JSON.stringify({ response: response.content }), {
            status: 200,
            headers: { 'Content-Type': 'application/json' }
        });
    } catch (error) {
        console.error('Upstream AI error:', error);
        // Fallback anggun: kembalikan sinyal fallback agar UI menyajikan jawaban terkurasi
        return new Response(JSON.stringify({
            fallback: true,
            error: 'Upstream unavailable'
        }), {
            status: 500,
            headers: { 'Content-Type': 'application/json' }
        });
    }
}
Desain Graceful Degradation: Jangan Tampilkan Error Kasar
Satu aturan penting pada web portfolio: pengalaman pengguna tidak boleh rusak hanya karena satu API pihak ketiga bermasalah.
Jika Workers AI mencapai limit harian atau koneksi timeout, komponen frontend (Chatbot.tsx) tidak menampilkan pesan kesalahan teknis seperti “500 Internal Server Error”. Sebagai gantinya, sistem mendeteksi fallback: true dan langsung beralih ke mode offline:
- Menampilkan banner halus: “AI offline — showing cached answers. Reach Muammar directly at muammarm28@gmail.com”.
- Memilih jawaban dari koleksi rangkuman fakta terverifikasi yang sudah tersimpan di browser.
- Tetap memberikan informasi relevan kepada recruiter tanpa hambatan.
Hasil dan Efisiensi
Setelah deployment berjalan:
- Kecepatan Respon: Waktu respons rata-rata berkisar antara 800ms hingga 1.4s.
- Biaya Nol Rupiah: Menggunakan alokasi free 10.000 neurons harian dari Cloudflare Workers AI sudah lebih dari cukup untuk menangani ratusan percakapan per hari.
- Transparansi: Status provider ditampilkan secara bangga melalui badge kecil
● Qwen 2.5 · Cloudflare Workers AIdi antarmuka portofolio.
Pendekatan ini membuktikan bahwa integrasi fitur AI modern tidak selalu memerlukan biaya langganan bulanan mahal atau infrastruktur server yang rumit. Dengan memadukan SSG Astro dan inference di Edge, kita bisa menyajikan antarmuka yang cepat, hemat, dan dapat diandalkan.